AI研修 大企業実務者向け / 第6章: 大規模AIを低コストで支える高速推論インフラ
本番APIの回復耐性とセッション管理
無料公開レッスン / 読了目安 2 分
大企業向けの共通AIプラットフォームとして推論サーバーを稼働させるには、アクセス集中時でもエラーを起こさない堅牢な回復耐性(フォールトトレランス)と、セッションの安定維持が求められます。
vLLM v0.27.0〜v0.28.0では、複数のノードにまたがる大規模分散配置(データ並列やエキスパート並列)において、一部ノードが脱落しても自動で検知・回復する「フォールトトレランスフレームワーク」が導入されました。さらに、Rustフロントエンドに「gRPCコントロールプレーン」を搭載し、アクティブなリクエストの安全な中断(abort)やAPI監視、サーバーのディスカバリ機能が統合されています。また、同時バッチ処理数を定める max_num_batched_tokens が16384へと倍増され、高負荷時のスループットが向上しました。
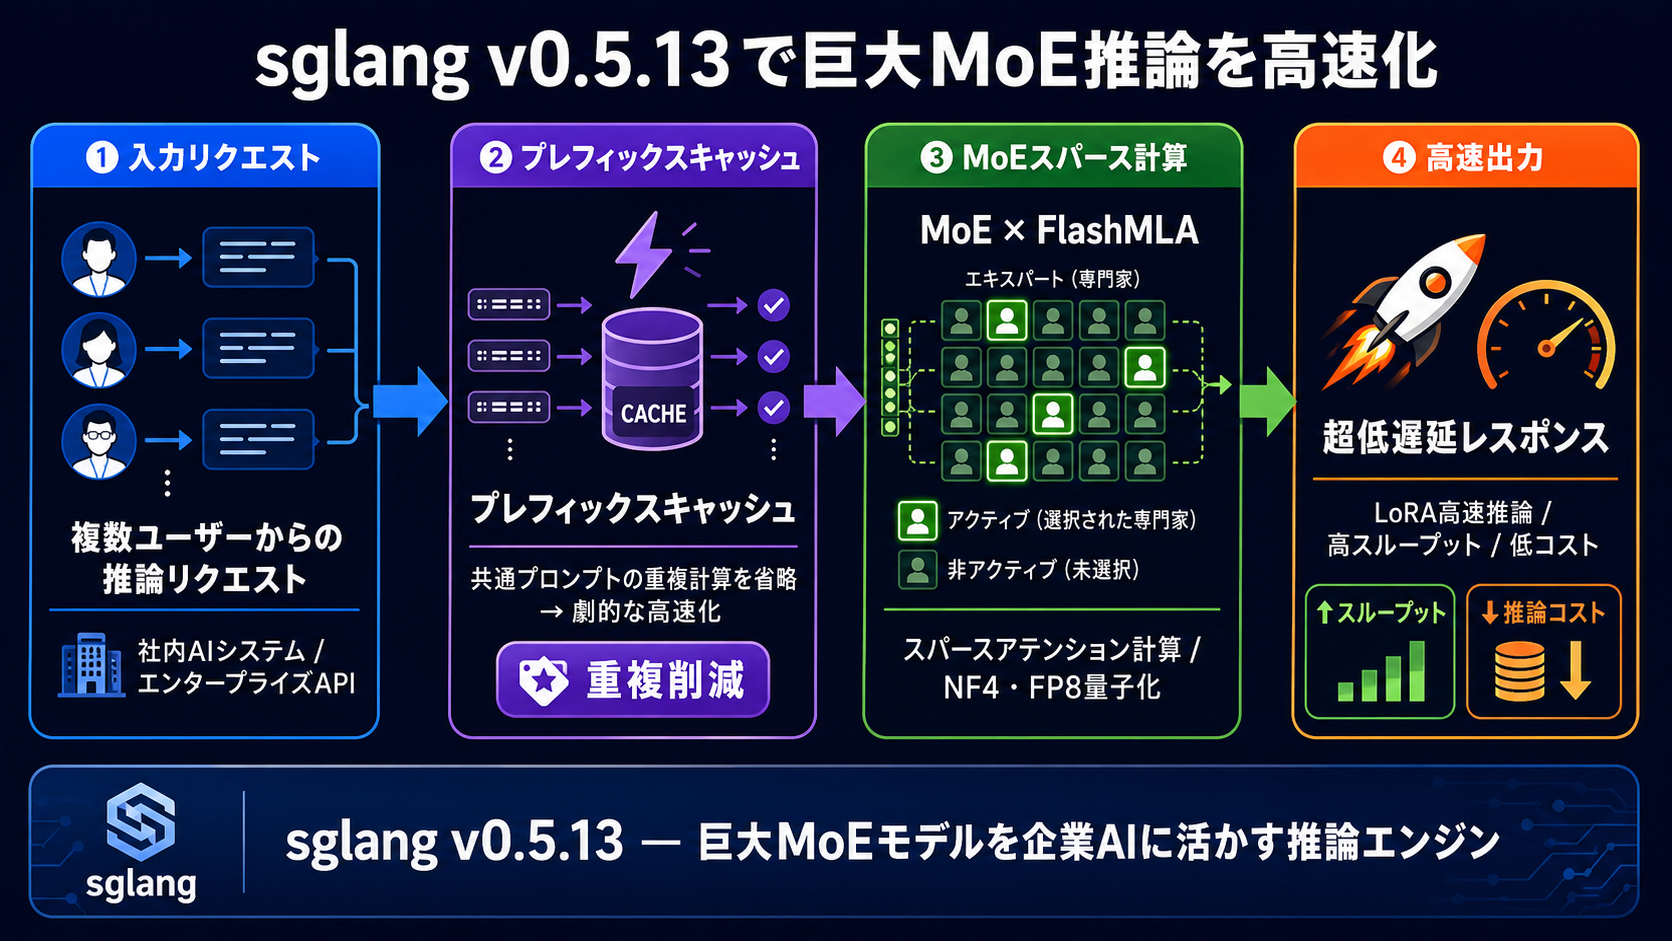
また、sglang v0.5.17〜v0.5.19では、マルチターンの自律エージェント運用に最適な「セッション参照対応 Unified Radix Cache(--enable-session-radix-cache)」やビームサーチが導入されました。エージェントがセッション(session_id)を維持している間、その履歴キャッシュがメモリ上から勝手に消去(eviction)されるのを確実に防ぎ、応答の超低遅延化と安定性を両立します。
関連動画
OpenAIが2026年4月23日にGPT-5.5を発表。4月24日の更新とDevelopersページではAPI提供も確認できます。
【速報】GPT-5.6&Work登場|性能&活用法4選!