AI研修 大企業実務者向け / 第6章: 大規模AIを低コストで支える高速推論インフラ
DSpark投機デコードとMoE融合カーネル
無料公開レッスン / 読了目安 2 分
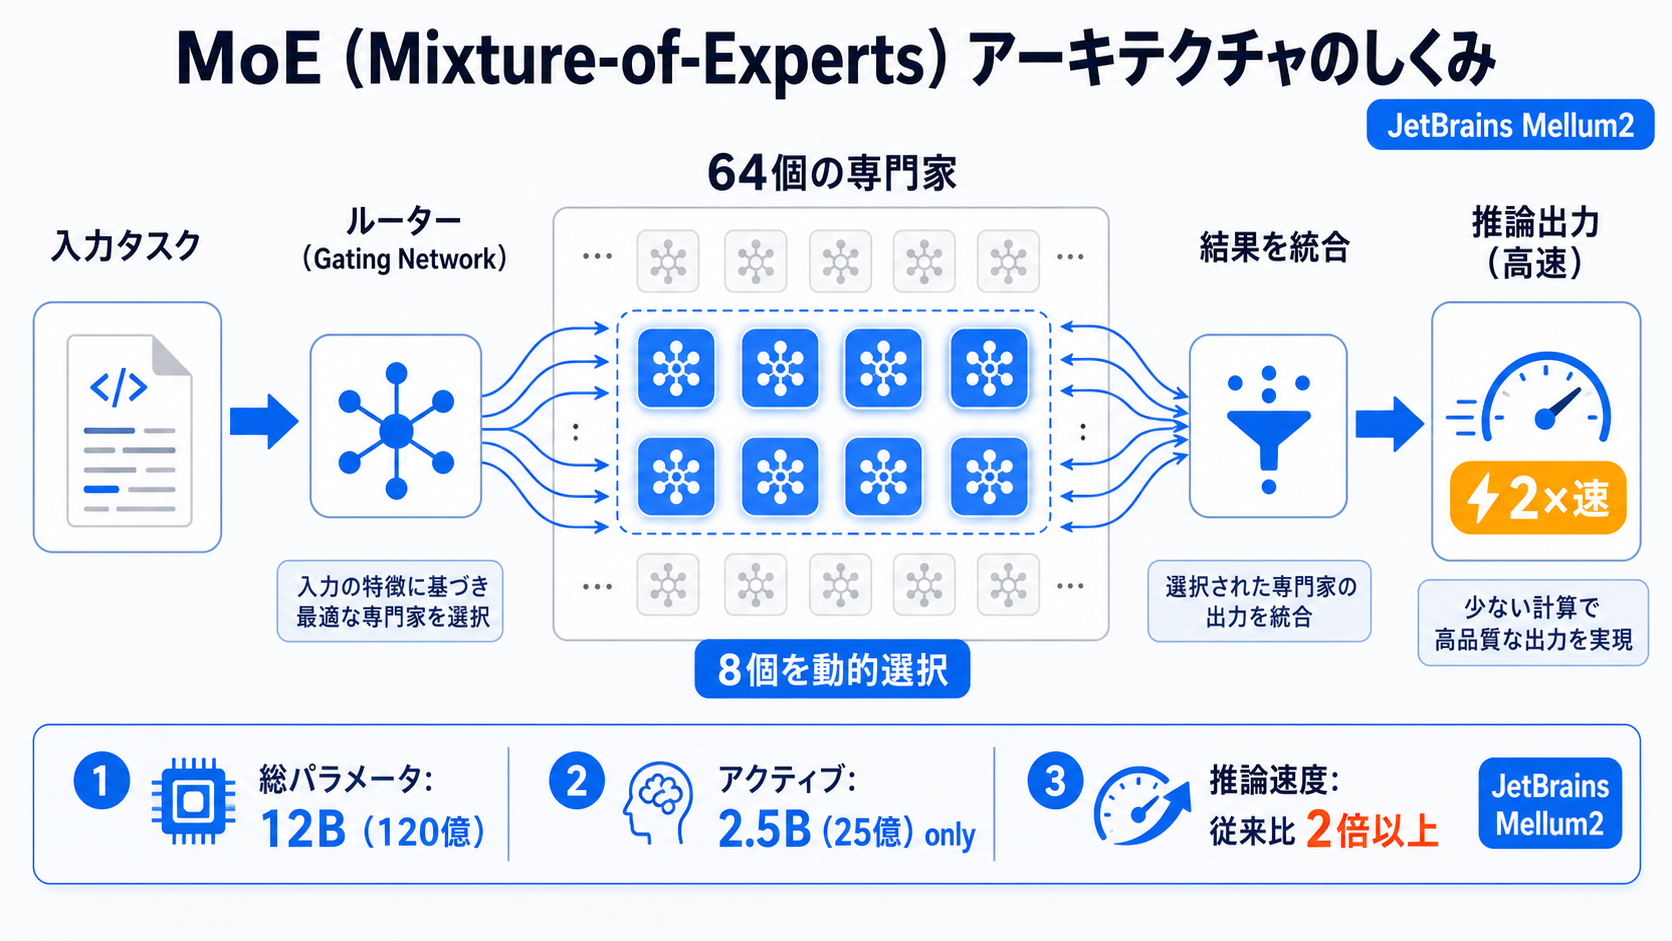
大規模運用のAPIコストを劇的に削減するためには、推論速度自体を高める投機デコード(Speculative Decoding)や、MoEモデルに特化したルーティング処理の最適化が不可欠です。
sglang v0.5.16に搭載された「DSpark」は、従来の固定長で下書きを生成する手法と異なり、ドラフトモデルの「確信度(Confidence)」に基づいて検証ウィンドウの長さを動的に伸縮させる革新的な投機アルゴリズムです。これにより、DeepSeek-V4-Proなどにおいて1GPUあたり秒間383.7トークンという圧倒的な超高速テキスト生成を達成しました。さらに、sglangはtop-k選択とページテーブル変換を単一の実行パスで処理する「TopK V2融合カーネル」を実装しています。
また、vLLM v0.24.0〜v0.28.0では、NVIDIAの「DeepEP v2」を統合し、複数エキスパートへのトークンルーティング処理負荷をLPLB(線形計画法)やWaterfillアルゴリズムで平準化しています。さらにDeepSeek V4のsparse MLAを投機デコードに適合させて推論速度を両立しています。これらのインフラ技術を有効化することで、ハードの限界に近い高速化と優れた費用対効果を獲得できます。
関連動画
【驚異】95 8%を叩き出したAI論文!#AI #人工知能 #生成AI #ディープラーニング #テクノロジー #最新論文
【95%削減】精度そのままでAIの電気代とトークンを削り落とす魔法のツールがヤバい