AI研修 大企業実務者向け / 第6章: 大規模AIを低コストで支える高速推論インフラ
KVキャッシュ退避と階層ストレージ
無料公開レッスン / 読了目安 2 分
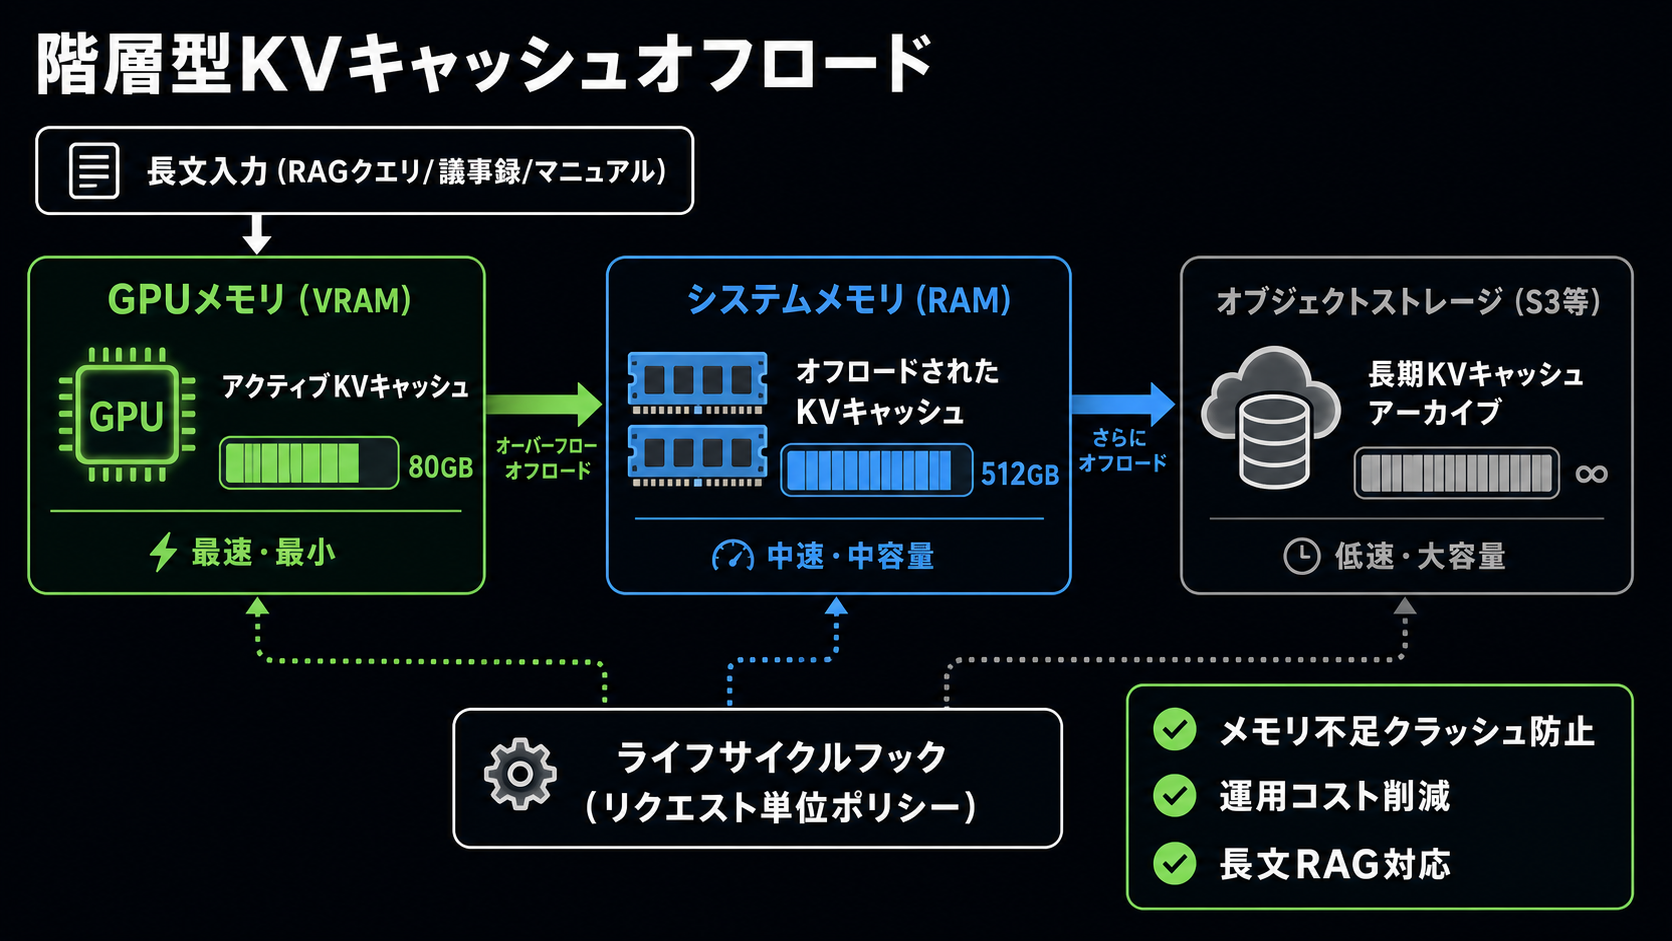
長文のビジネス文書を扱うRAGや、複数ターンの会話履歴を持つエージェント運用において、GPUのビデオメモリ(VRAM)がKVキャッシュによって枯渇する問題は極めて深刻です。この問題を解決するため、最新の推論エンジンはVRAMからデータを別の記憶階層へと退避させる「階層化(Tiered)セカンダリストレージ」技術を実用化しています。
例えば、vLLM v0.26.0では、VRAMに収まりきらないKVキャッシュデータをCPUホストメモリやローカルファイル、さらにはS3などのオブジェクトストアへと非同期でオフロード(退避)する機能を実装しました。また、sglang v0.5.16では「--enable-flexkv」オプションにより、FlexKVのKVManagerを介してホストDRAMやNIXL DRAM/ファイルへとシームレスにキャッシュを退避できます。
さらに、sglang v0.5.19では全モデルで「Unified Radix Tree」が標準化され、コンテキストの再利用率が飛躍的に向上しました。これにより、システムのビデオメモリ容量の物理的な上限をはるかに超えるコンテキスト処理が可能となり、メモリ不足によるクラッシュ(OOM)を防ぎつつ、安価なハードウェアで長文検索(RAG)を安定稼働させられます。
関連動画
KV Cache Explained: The Trick Making AI Much Faster ⚡
なぜ80億のAIが6GBのグラボ1枚で鍛え直せるのか|LoRAとRAG【ゆっくり解説】