AI研修 大企業実務者向け / 第6章: 大規模AIを低コストで支える高速推論インフラ
超巨大MoEモデル「Kimi K3」の自社運用
無料公開レッスン / 読了目安 2 分
Moonshot AIが開発した「Kimi K3」のような2.8兆パラメータの超巨大MoE(混合専門家)モデルを、外部クラウドAPIに依存せず自社のプライベートサーバーで安定して動かすためのインフラ最適化技術を学びます。Kimi K3は896個のエキスパートを抱え(同時起動は16個)、最大100万トークンという極めて長い文脈窓を持ち、ネイティブMXFP4形式を採用しています。
この超巨大モデルの登場に対し、推論エンジンのvLLM(v0.27.0〜v0.29.0)やsglang(v0.5.17〜v0.5.19)は迅速にサポートを実装しました。特にvLLMの「shared-expert sharding(共有エキスパート分割)」機能は、重複する共有エキスパートを複数GPU間で分割配置することで、GPU1枚あたり約17GiBという劇的なメモリ削減を実現します。
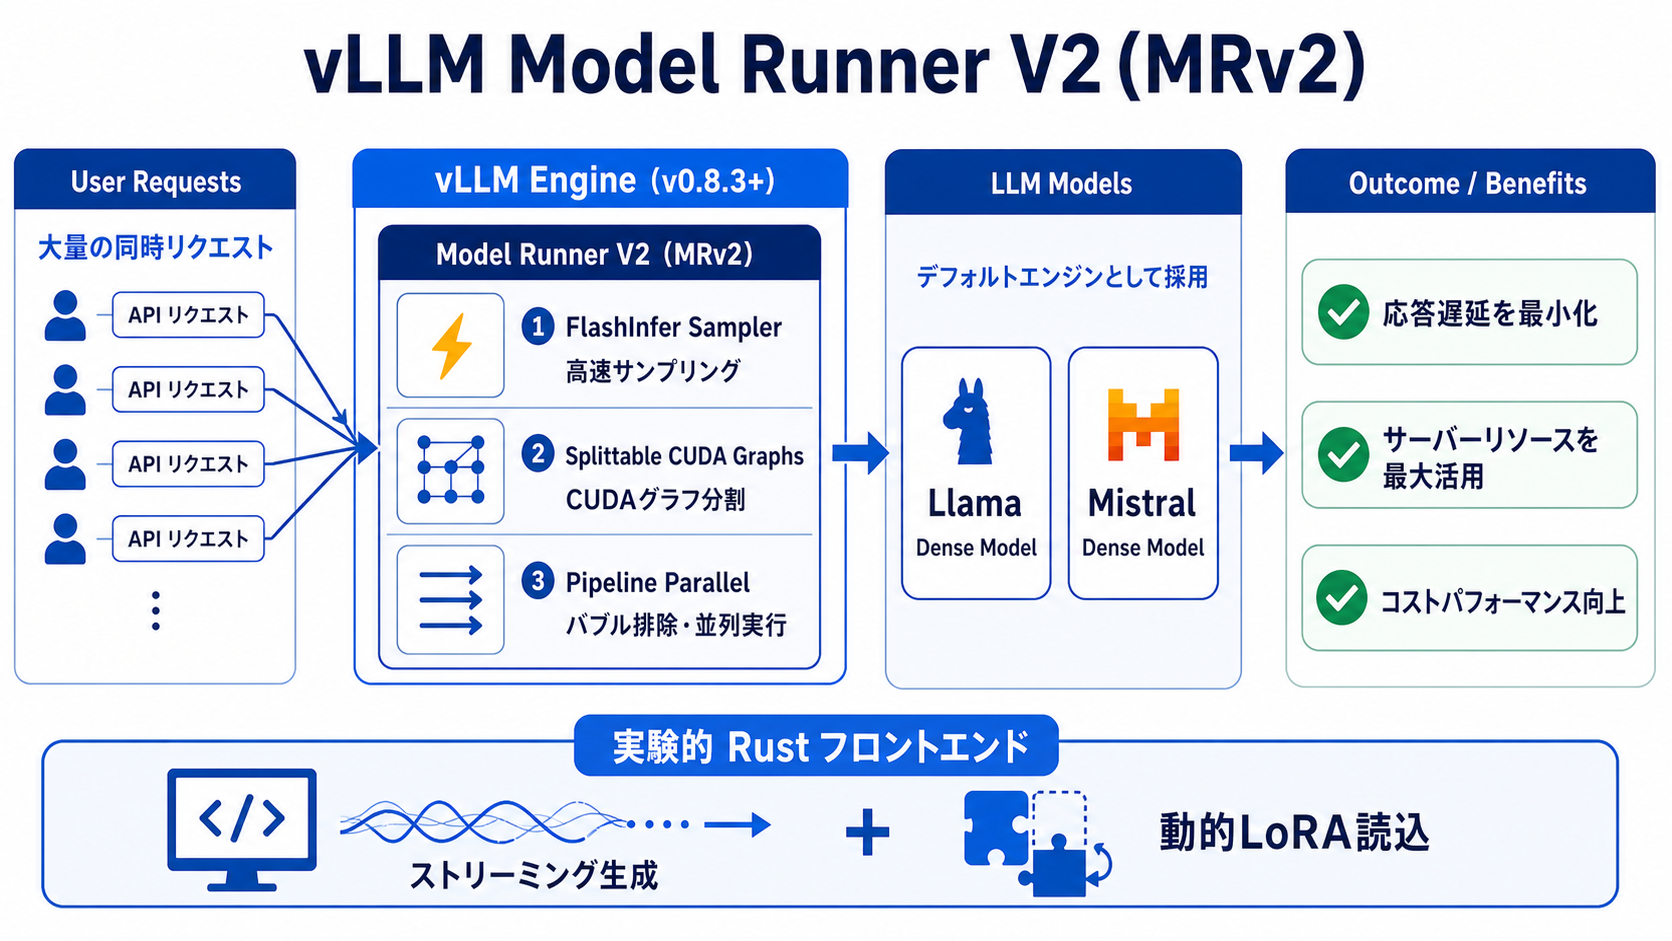
さらに、DeepGEMMによる行列演算の高速化やvLLM v0.29.0におけるMRV2(Model Runner V2)の全面採用により、推論スループットとメモリ効率が大幅に向上しました。高価なハードウェア投資を最小限に抑えつつ、最高峰の自律AIを自社サーバー上に完全なクローズド環境で配備することができます。
関連動画
LongCat 2.0 Proves GPUs Aren't Required #tech #ai
【速報】Fable 5超え!? 中国AI「Kimi K3」の衝撃を1分で解説