AI研修 大企業実務者向け / 第5章: 機密データを保護するエッジAIとローカル推論
llama.cppによるVulkan/Metal最適化
無料公開レッスン / 読了目安 2 分
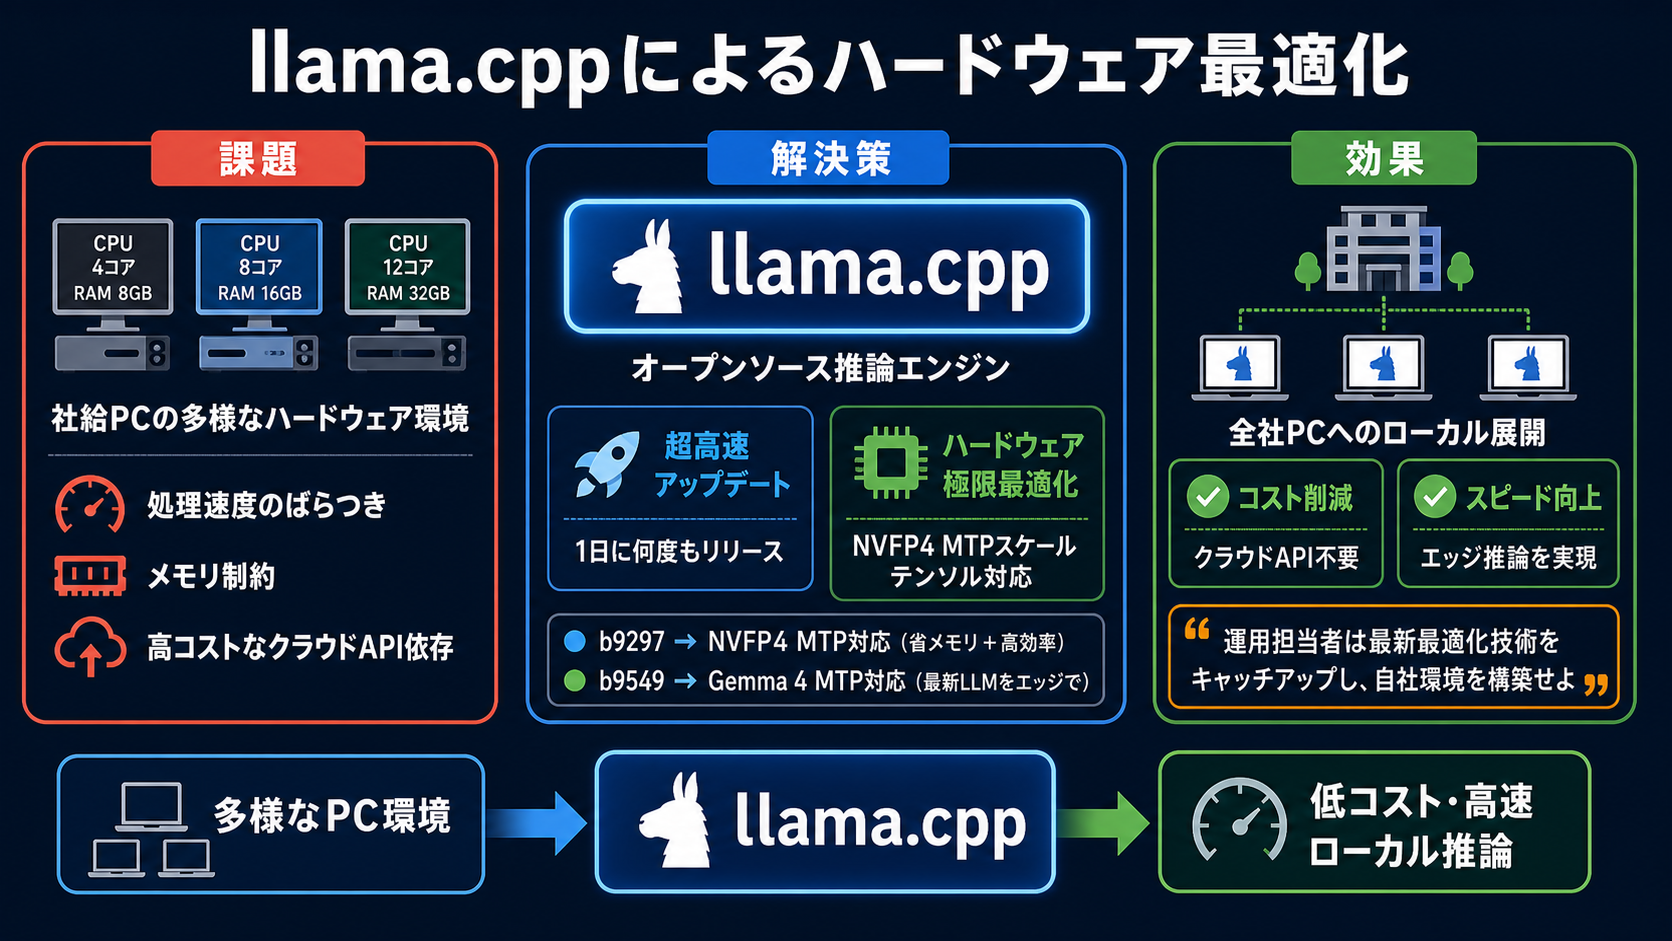
支給PCなどの限られた計算リソースで、最先端のモデルを実用的な応答速度で動かすための強力な基盤となるのが「llama.cpp」です。llama.cppは、NVIDIAのCUDA環境だけでなく、WindowsやLinuxで幅広く普及している「Vulkan」や、MacのApple Siliconに最適化された「Metal」など、多様なプラットフォームのハードウェアにネイティブ最適化された推論ランタイムを提供します。
最新のリリース(b10194やb10106など)では、量子化モデルをバッチサイズ1で稼働させる際の「転置フリーgemmv(行列ベクトル乗算)演算カーネル」の追加やメモリ割り当ての最適化など、細かなレベルでの調整が継続的に盛り込まれています。これにより、高価なAI専用サーバー群を新たに調達することなく、手元のノートPCや既存端末に内蔵されたGPU/CPU性能を極限まで使い切ることができます。
完全に閉じたネットワークやオフライン環境で動作するため、社外の通信障害時でも業務を停止させないBCP(業務継続計画)の観点からも極めて高い価値と親和性を発揮します。
関連動画
#00Mac1台で学ぶ ローカルLLMファインチューニング超入門 〜MLX × LoRAで議事録AIまで〜
今一番注目しているローカルLLMを完全解説!自分のパソコンで完結するローカルLLMについてAIのプロの視点からお話しします